
在上海浦东的一座数据采集工厂里,数十台人形机器人每天重复着同一批动作:抓起一个杯子、放到指定位置、再抓下一个。采集员通过遥操作设备一遍遍纠正它们的轨迹,机器视觉、关节角度、力控反馈等数据随之汇入后台。
同一时刻,类似的场景正在成都、无锡、南昌、苏州、天津、北京、深圳等几十个城市同步上演。
这些看似枯燥的"重复劳动",正是当下中国具身智能产业最重要的一场基础建设。
中国信息通信研究院近期发布的《具身智能训练场研究报告(2026年)》,第一次系统晒出了这个行业的"家底":截至2026年6月底,全国已建成启用超过70家具身智能训练场(数采中心),在建或规划中的还有46家,覆盖全国18个省级行政区。
如果说过去两年行业的关键词是"造机器人、训大模型",那么这份报告传递出的信号非常明确:具身智能正在进入"数据基建"阶段——谁掌握了真实世界数据的生产能力,谁就握住了下一轮竞争的入场券。
信通院报告揭开家底:具身智能正在打响"数据基建战"
为什么整个行业突然开始"囤数据"?答案藏在一个朴素的判断里:机器人要真正"会干活",靠的不是"看过"的数据,而是"做过"的数据。
大语言模型的幸运在于,人类上千年的文字积累和全球60多亿网民,为它准备了约300万亿词元(token)的现成教材。而机器人需要的视觉、动作、关节扭矩、力触觉等多模态交互数据,此前从未被系统性地记录过,无法从互联网直接获取,只能从零开始、逐条生产。
一个简单的抓取动作背后,涉及视觉感知、空间理解、动作规划、轨迹控制、力度反馈和成败判定,这些数据必须让机器人进入真实物理环境,通过大量实践持续积累。
信通院报告用一组测算说明了缺口有多大:假设机器人迎来"ChatGPT时刻"需要训练1.1万亿token的数据,若全部依靠真机采集,约需21200台机器人连续工作一整年,产出千万小时级的有效数据。而目前全球可用的高质量真实数据,总共只有数十万到百万小时级。
差距就是机会。
报告援引的海外案例同样印证了数据的价值:预训练数据规模翻近一倍,任务成功率提升约1.5倍——数据对能力的拉动可以被直接量化。
人工智能科学家李飞飞也明确指出:仿真数据与真实数据是互补关系,但真实数据提供真实世界的物理约束,是模型落地不可替代的部分。
正是在"数据饥渴"的倒逼下,训练场这种新型基础设施在中国率先实现了规模化建设。
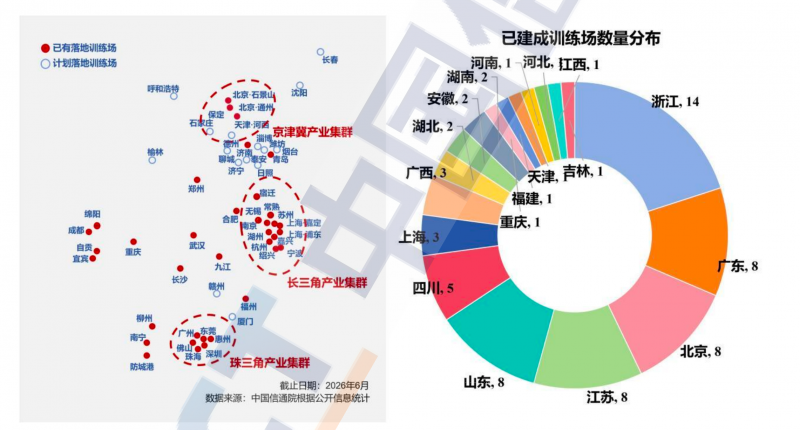
从报告披露的版图看,训练场已形成长三角、京津冀、珠三角三大集群:浙江以14家居首,广东、北京、山东、江苏各有8家,四川5家,上海、广西各3家,湖北、安徽、湖南各2家,河南、河北、江西、吉林、天津、福建、重庆也均有落地。
从华北的北京、天津、河北雄安周边,到华东的沪苏浙皖,再到华南的粤桂两地,一张覆盖多层级城市的数据基础设施网络已经铺开。
仅长三角一地,上海人形机器人麒麟训练场、智元机器人数据采集工厂、银河通用苏州具身智能数据采集中心、杭州市人形机器人中试基地、合肥市具身智能机器人数据采集预训练场等,总占地面积就超过7万平方米。
政策层面的信号同样清晰。
工业和信息化部等八部门在《"人工智能+制造"专项行动实施意见》中明确提出建设人形机器人中试基地和训练场;工信部与国务院国资委联合开展实景实训专项行动;国家发展改革委提出以训练场和中试基地为抓手,构建高质量真机数据采集系统,破解具身智能训练的"数据饥渴";国家数据局则部署建设行业高质量数据集。2024年至2026年6月,各地方政府已累计发布超过40份相关政策文件。
数采中心不是某一家的生意:智元、星海图、银河通用都在"囤数据"
一个容易被外界忽略的事实是:建数采中心,从来不是某一家企业的"独门生意",而是全行业的集体动作。
按建设运营主体统计,走在最前面的是"国地中心体系"——由国家级平台北京人形机器人创新中心牵头,依托上海主训练场"麒麟",联动北京、河南、深圳、河北、重庆、吉林、陕西榆林、江苏常熟和吴江等9个分训练场,共10处。
企业侧布局最广的是智元机器人,已在上海浦东/临港、成都郫都、无锡、南昌、嘉兴、重庆、珠海、贵安等地建成或签约9处数据采集中心和训练场;优必选、帕西尼感知、乐聚机器人各有5处,鹿明机器人有3处;京东、睿尔曼、银河通用、星海图、蓝思科技、卧安机器人、中联重科、群核、零次方、箸境、开普云、优奇等12家企业也各有1处。
智元的打法颇具代表性。
其位于上海浦东的数据采集工厂构建了家居、餐饮、工业、商超、办公等真实场景,设置超过200个细分场景任务、覆盖3000多类操作物品,除供给自身研发外,还对外开源了AgiBotWorld系列真实数据集。
以张江数采工厂为中心,智元还在向全国多家合作训练场输出数据采集能力,统一数据标准、统一回流,形成"行业合作方协同"的模式。
在上海创智学院与智元联合发布的最新成果中,通过实时回流机器人在真实环境中的任务执行数据更新模型,长程任务的平均子步骤得分较传统监督微调方法提升近50%——数据飞轮的效果已经可以被量化。
在深圳,智元与玉禾田集团子公司联合建设具身智能机器人智创中心,围绕环卫、保洁场景采集垂域数据;在江西南昌龙旗科技园,智元机器人完成了流水线全闭环操作。
其他玩家的路径各有侧重。
星海图也参与了人形机器人数据采集中心的建设,成为这一轮数据基建中的一员。
京东一边在江苏宿迁联合地方政府建设数据采集社区、开源第一视角数据集,一边上线具身智能数据交易平台。
帕西尼在天津建成1.2万平方米的超级数据采集工厂,预计数据年产量达数亿条,今年5月还完成了具身智能数据的合规出口。
把这些名字放在一起看,结论一目了然:数据采集不是某家公司讲的"故事",而是机器人行业为自身迭代必须补上的基础设施课。
机器人本体是"身体",具身大模型是"大脑",真实世界数据则是支撑能力进化的"教材"和"养料"——没有教材,再好的身体和大脑也学不会干活。
从"建起来"到"转起来":数据飞轮一旦转动,就是整个行业的红利
当然,把训练场建起来只是第一步。信通院报告也没有回避问题:当前训练场存在场景任务同质化、数据实际产能有限、流通性不足、可持续商业模式尚未形成等共性挑战,行业整体正从"建设热潮期"迈向"能力沉淀期"。
但更值得关注的是,"转起来"的迹象已经出现。
在产能端,报告预计已启用的训练场2026年数据年产量累计将达到千万小时级;真机遥操作数据在规模化运营后,单小时有效成本已降至约275元,数据生产的工程化流水线正在成形。
在交易端,2026年初,全国首单"具身智能数据集"在江苏省数据交易所上架并完成交易;北京、贵阳等地数据交易所陆续推动具身智能数据上架;京东云、百度智能云、鹿明机器人等相继推出数据交易平台和"数据超市"。
在生态端,上海麒麟训练场带动浦东张江模力社区汇聚超过200家具身智能上下游企业,"上下楼就是上下游"的产业生态初见雏形。
一条完整的闭环正在形成:机器人进入真实场景,产生真实数据;数据训练模型,模型提升能力;能力更强的机器人进入更多场景,产生更多数据。
这个"数据飞轮"一旦转动起来,受益的将不只是某几家企业,而是整条产业链——本体企业获得训练验证的低试错成本环境,模型企业获得高质量数据供给,地方政府则把本地的制造、物流、零售、医疗等场景资源,转化为面向未来的数据资产和产业入口。
这也是各地政府争相布局数采中心的底层逻辑:它在为整个行业铺设数据的轨道。轨道铺得越早、越密,产业这趟列车就跑得越快。
当越来越多的机器人走进数采中心"上岗",中国具身智能也正在从"造机器人、训模型",跨入"数据、模型、本体、场景协同进化"的新阶段。
这场静悄悄的数据基建,或许不会每天登上头条,但它正在决定中国机器人产业未来五年的身位。
报道热线:010-83834755 投稿邮箱:news@cenr.com.cn 在线客服QQ:1752551731
China Enterprise Report 中国企业报道版权所有 《工业和信息化部网站备案许可证》编号: 京ICP备14006871号-1
本站常年法律顾问:北京楹庭律师事务所 孟雷 律师


